强化学习基础
强化学习(reinforcement learning,RL)讨论的问题是智能体怎么在复杂、不确定的环境中最大化它能获得的奖励。强化学习由两部分组成:智能体和环境。在强化学习过程中,智能体与环境一直在交互。智能体在环境中获取某个状态后,它会利用该状态输出一个动作 ,这个动作也称为决策。然后这个动作会在环境中被执行,环境会根据智能体采取的动作,输出下一个状态以及当前这个动作带来的奖励。智能体的目的就是尽可能多地从环境中获取奖励。
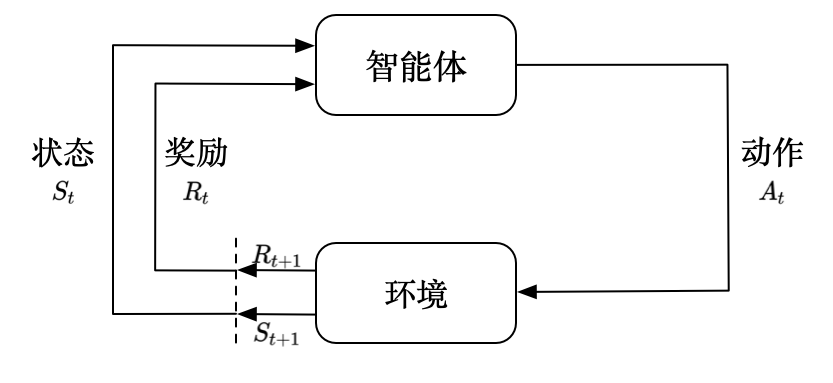 强化学习是一类解决序列决策问题的计算方法。一个智能体(Agent) 处在某个环境(Environment) 中,在每个时刻观察环境的状态(State),据此选择一个动作(Action);环境接收动作后转移到新状态,并给智能体一个标量奖励(Reward) 作为唯一的反馈信号。智能体的目标是最大化整个交互过程中的累积奖励。
关于奖励,如果只看眼前的单步奖励,智能体就会变得非常“短视”。因此,智能体真正关心的目标是累积回报(Return),也就是从当前时刻 t 开始,直到一局游戏结束,未来所有奖励的总和。但是,把未来的奖励直接加起来有一个问题,越远未来的奖励越不确定,为了未来的奖励不如现在的奖励更值得,可以引入折扣因子,未来的奖励在加和时就会被打个折扣。
机器学习范式的对比
机器学习通常被分成三大范式:监督学习、无监督学习和强化学习。
- 监督学习是指有人提前标好了答案,模型从
(输入, 标签)对中学习映射关系,例如训练数据中会有(图片1, 猫),(图片2, 狗),它的目标就是最小化预测与标签之间的误差,本质上是拟合一个静态的映射函数,且数据是独立同分布的; - 无监督学习就是没有标签,让模型自己发现数据的结构,聚类、降维、生成模型都属此类;
- 强化学习没有标签,但有反馈,